Reinforcement learning: wanneer wel en wanneer niet
Reinforcement learning leert door te proberen: een model neemt steeds een beslissing, krijgt een beloning of straf, en wordt zo beter. Het werkt goed voor robots, spellen en beslissingen die elkaar beïnvloeden, zoals magazijnen en dynamische prijzen. Voor de meeste bedrijfsvragen is een eenvoudiger aanpak sneller en betrouwbaarder, en dat zeggen we je eerlijk.
Wat het doet
- Robots en voertuigen leren bewegen in een ruimte
- Beslissingen na elkaar optimaliseren, zoals voorraadbeleid
- Prijzen of aanbiedingen bijsturen op wat werkt
- Planningen leren die zich aanpassen aan drukte
- Strategieën testen in een simulatie voordat ze echt gaan
Bijvoorbeeld
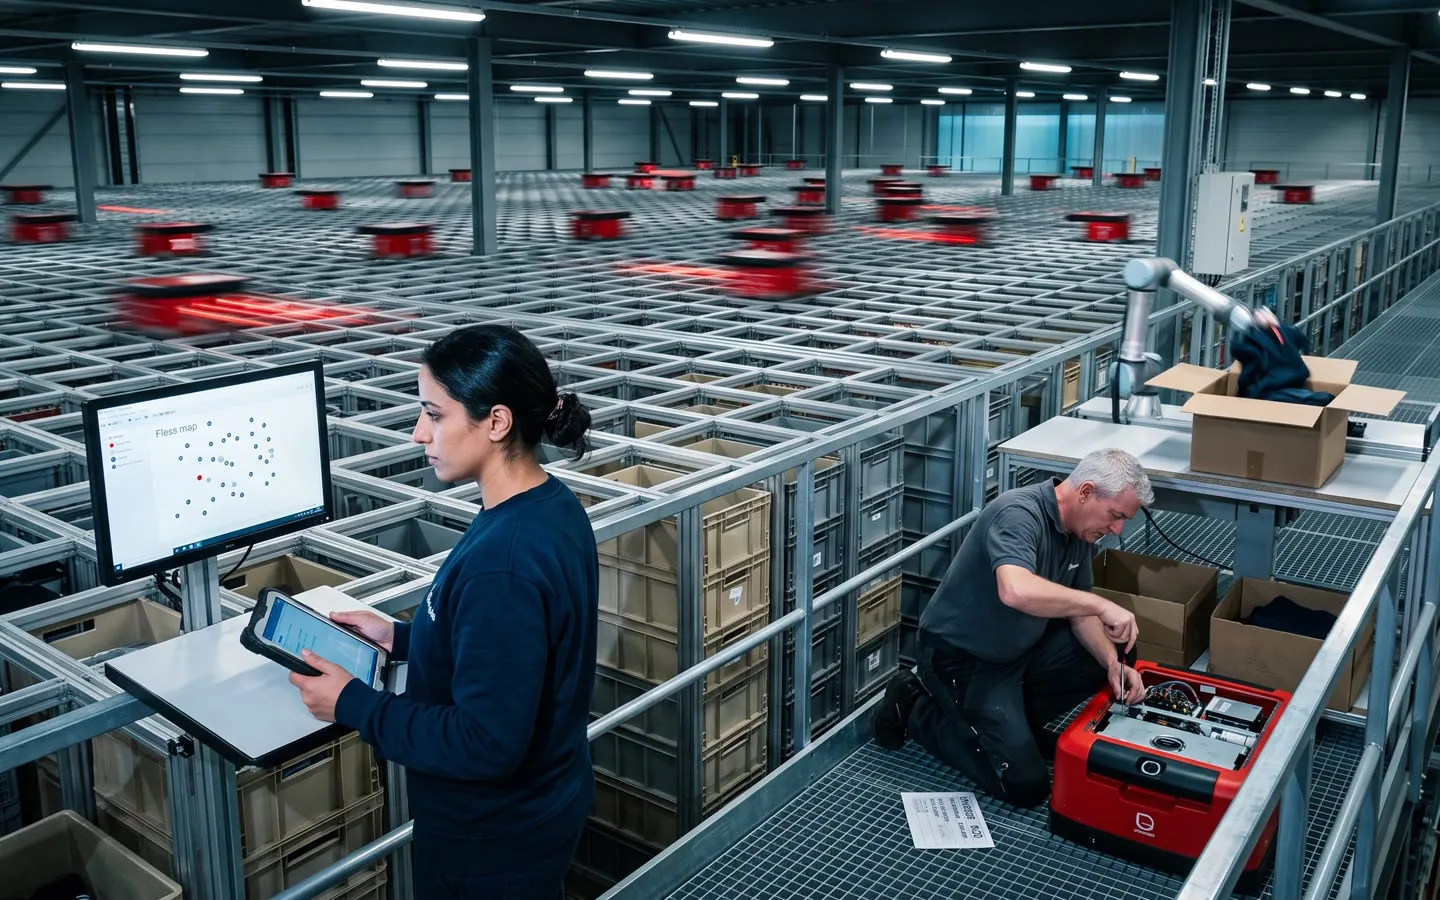
Een rastermagazijn met robots wil de volgorde van bakken zo kiezen dat de pickers minder wachten. We bouwen eerst een simulatie van het magazijn en vergelijken daarin een slimme vaste regel met een model dat leert. Pas als het lerende model in de simulatie duidelijk wint, gaat het op de vloer proberen.
Hoe het werkt
- 01
Is het de juiste vraag?
Gaat het om beslissingen na elkaar, die elkaar beïnvloeden, met een duidelijke beloning? Zo niet, dan is een ander model beter.
- 02
Een simulatie
Reinforcement learning leert door te proberen, en proberen doe je liever in een simulatie dan in je bedrijf.
- 03
Vergelijken met eenvoudig
We zetten het lerende model altijd naast een goede vaste regel of een optimalisatie. Wint het niet, dan nemen we het eenvoudige.
- 04
Voorzichtig naar de praktijk
Eerst meekijken, dan een klein deel, met grenzen die het model nooit mag overschrijden.
Wat je nodig hebt
- Een beslissing die steeds opnieuw wordt genomen
- Een maat voor wat een goede uitkomst is
- Gegevens of kennis om een simulatie te bouwen
Zo begin je
Het hele traject loopt in de route AI aan het werk zetten.
Vragen
Wanneer is reinforcement learning de juiste keuze?
Als een model steeds opnieuw moet kiezen, de keuzes elkaar beïnvloeden, er een duidelijke beloning is en je veilig kunt oefenen in een simulatie. Robots, magazijnen, dynamische prijzen en sommige planningen voldoen daaraan.
Waarom raden jullie het vaak af?
Omdat het veel data of een goede simulatie vraagt, lastig uit te leggen is en onvoorspelbaar kan zijn. Voor de meeste bedrijfsvragen haalt een optimalisatie of een voorspellend model hetzelfde, sneller en betrouwbaarder.
Wat heeft ChatGPT met reinforcement learning te maken?
Taalmodellen worden na hun training bijgestuurd met reinforcement learning uit menselijke feedback (RLHF). Dat is iets anders dan het inzetten voor een beslissing in je eigen bedrijf.
Een halfuur gratis sparren over of reinforcement learning bij jou past?
Waar loop jij tegenaan in je bedrijf? Wat kan beter? Wat kan sneller? Wat gaat nog met de hand en moet nodig geautomatiseerd worden?
- Een halfuur sparren over jouw idee, gratis
- Je weet direct welke route het is, hoeveel weken, en wat het kost
- Ruwe inschatting over de prijs en het aantal weken
„Een Google Maps voor ons magazijn, met filemelding bij stelling 12.”
Distributiecentrum, Waalwijk
Vertel me je probleem, je geniale idee of stel gewoon wat vragen!
Alexander Kaan, product designer