Is dit al gefactcheckt? Antwoord met bron
Een zoeklaag die een screenshot of een stuk tekst koppelt aan factchecks die al bestaan, zonder zelf te oordelen.
- Open data
- AI
- Platform
- Jaar
Doublecheck kijkt of een bewering al door een factchecker is nagelopen. Je stuurt een screenshot of een stuk tekst, en terug komt wie de bewering uitzocht, wanneer en wat eruit kwam. Het is bedoeld als laag onder andere apps, zoals een browserextensie. Wij bouwden de zoeklaag en een index van 79.676 beweringen in 38 talen. Het is een experiment, en het draait nog alleen bij ons.
- Python 3.12
- FastAPI
- sentence-transformers
- PDQ-beeldhashes
- Tesseract OCR
- SQLite en numpy
- pytest
In het kort
- 79.676
- 1.596
- 38
- 5
- 1.682
Wat er lag
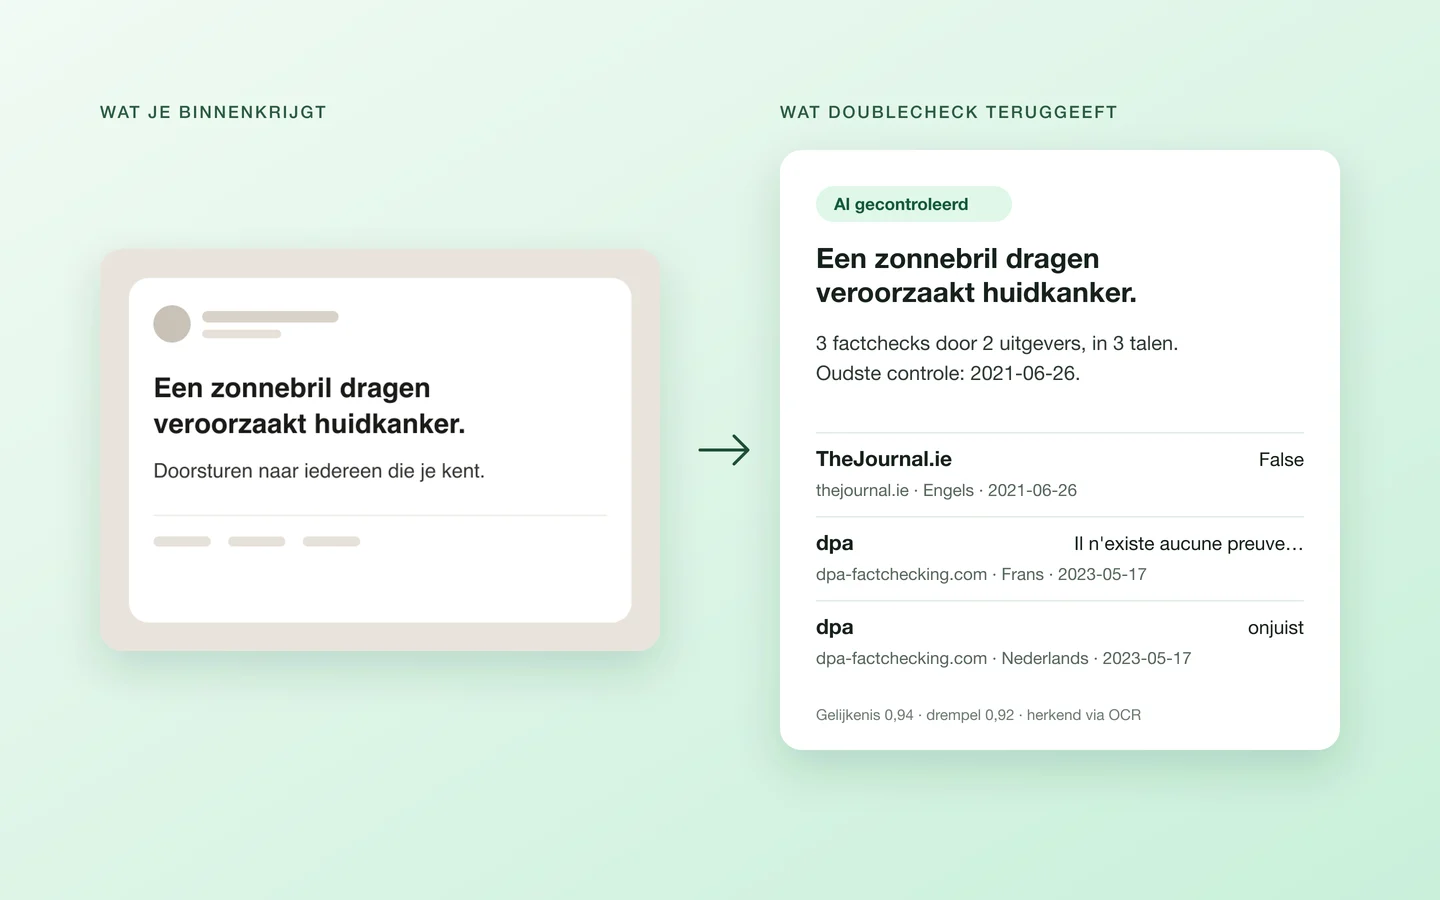
In de groepsapp komt een screenshot binnen: een zonnebril dragen veroorzaakt huidkanker. Er staat geen bron bij, en je wilt weten of het klopt voordat je iets terugstuurt. Laat je een AI-model oordelen, dan heb je alleen een nieuwe bewering die je weer moet checken. Daarom stelden we een kleinere vraag: heeft iemand dit al uitgezocht, en wie? Zo'n factcheck kan in een andere taal staan dan het screenshot. En het antwoord mag nooit verder gaan dan wat de factcheckers zelf schreven.
Drie details die het verschil maken
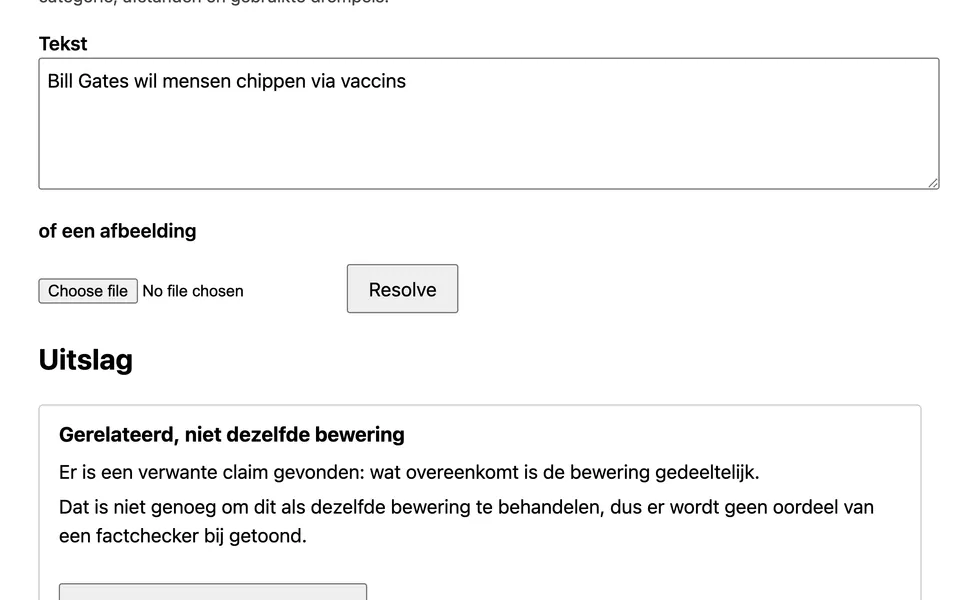
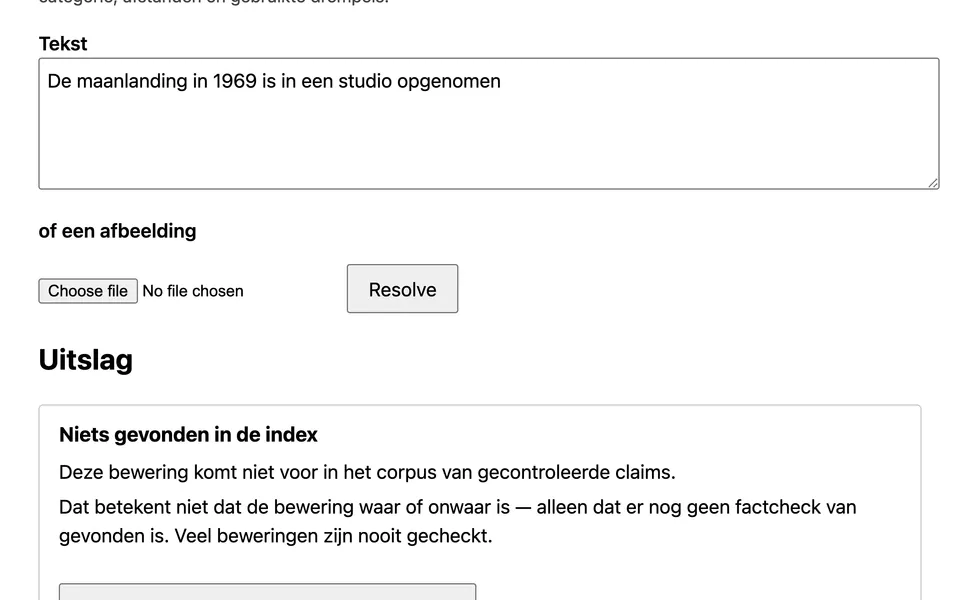
Van screenshot naar factcheck, over taalgrenzen heen
Drie factchecks bij één screenshot
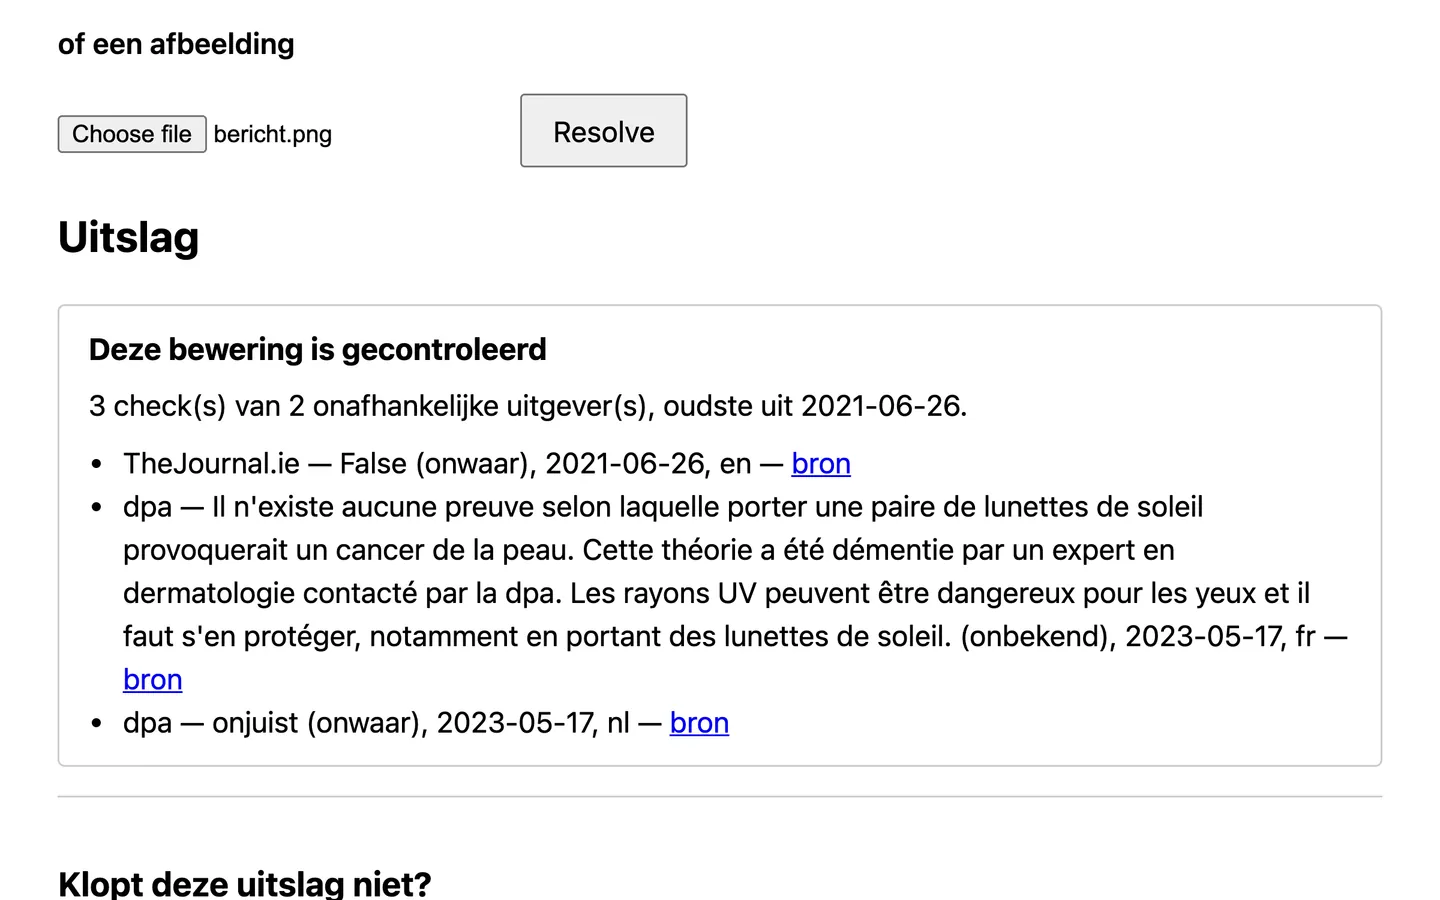
Het screenshot over de zonnebril maakten we zelf als voorbeeld, en we stuurden het naar Doublecheck. Hij las de tekst uit het beeld en vond drie factchecks van twee uitgevers. TheJournal.ie schreef in het Engels, dpa in het Frans en in het Nederlands, elk met een datum en een link naar de bron.
Dat lezen lukt in het Nederlands, Engels, Duits, Frans en Spaans. Daarna zoekt Doublecheck in bijna tachtigduizend gecontroleerde beweringen naar dezelfde bewering, ook in een andere taal. Er zijn drie antwoorden: gecontroleerd door deze uitgevers, iets verwants gevonden, of niets gevonden. Of iets waar is, zegt Doublecheck zelf nooit.
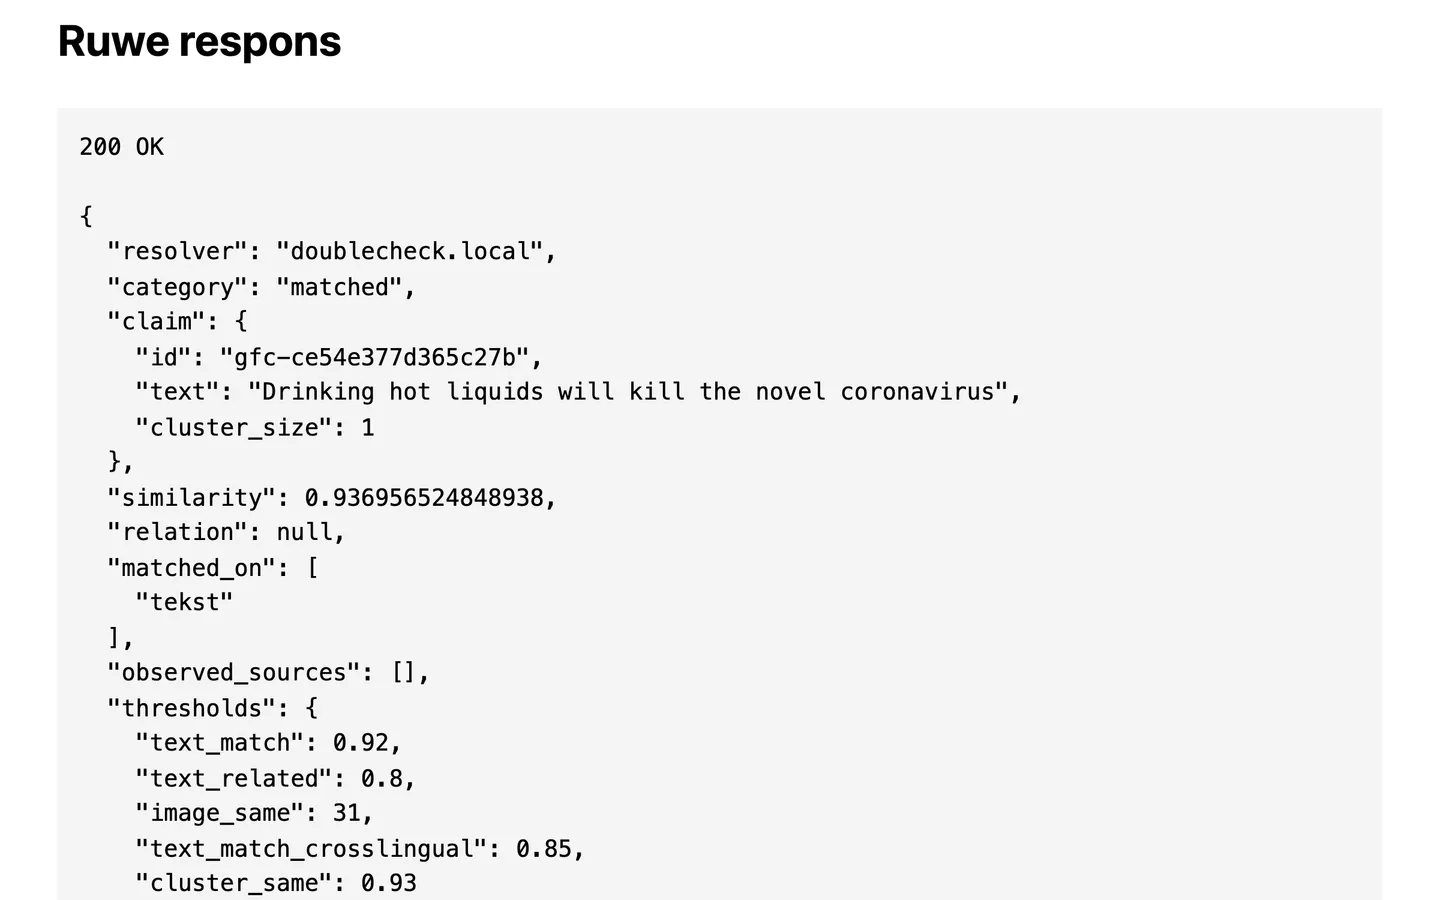
384 getallen per bewering
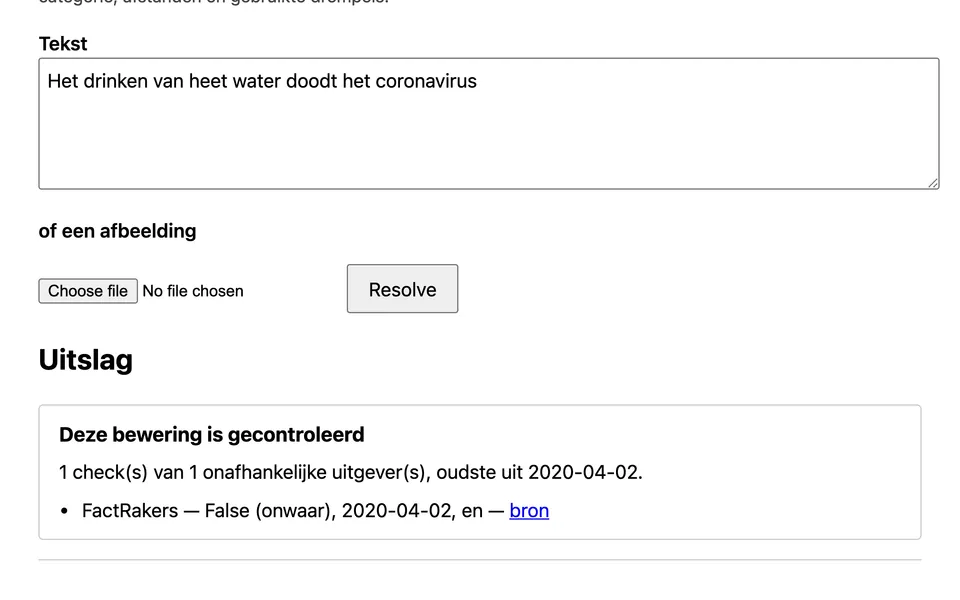
Bij de Nederlandse zin over heet water vond Doublecheck een Engelse factcheck, met een gelijkenis van 0,937. Dat kan omdat elke bewering in een meertalig taalmodel een rij van 384 getallen wordt. Dezelfde bewering ligt dan in het Frans en in het Nederlands dicht bij elkaar.
Een match telt pas vanaf een gelijkenis van 0,92, en tussen twee talen vanaf 0,85. Tussen 0,80 en de drempel heet een bewering verwant, en dan blijft het oordeel van de factchecker weg. Elk antwoord draagt de drempels en het model waarmee het gemaakt is, zodat je het kunt narekenen.
De 80.555 factchecks van 1.596 uitgevers komen uit de open feed van Data Commons, onder een licentie die doorgeven toestaat. Een taal mag pas in de index als het model hem aantoonbaar kan lezen. Drie talen gingen er daarom weer uit. Zoeken loopt nog langs alle beweringen tegelijk. De traagste vraag deed er 479 milliseconden over, net onder de halve seconde die we onszelf als grens stelden. Bij twee keer zoveel beweringen is een echte zoekindex nodig.
Een test die valt over het woord waarheid
Een test loopt elke vorm van antwoord langs op velden als waarheid, waarschijnlijkheid of geloofwaardigheid. Staat er ergens zo'n veld, dan valt de test om. Afspraken zijn makkelijk te vergeten, dus staan de belangrijkste in de code. Een factcheck zonder uitgever of zonder link kan de index niet in. Een drempel komt alleen uit de configuratie, en twijfel maakt een drempel nooit ruimer. Is de index met een ander model gebouwd, dan weigert Doublecheck te zoeken.
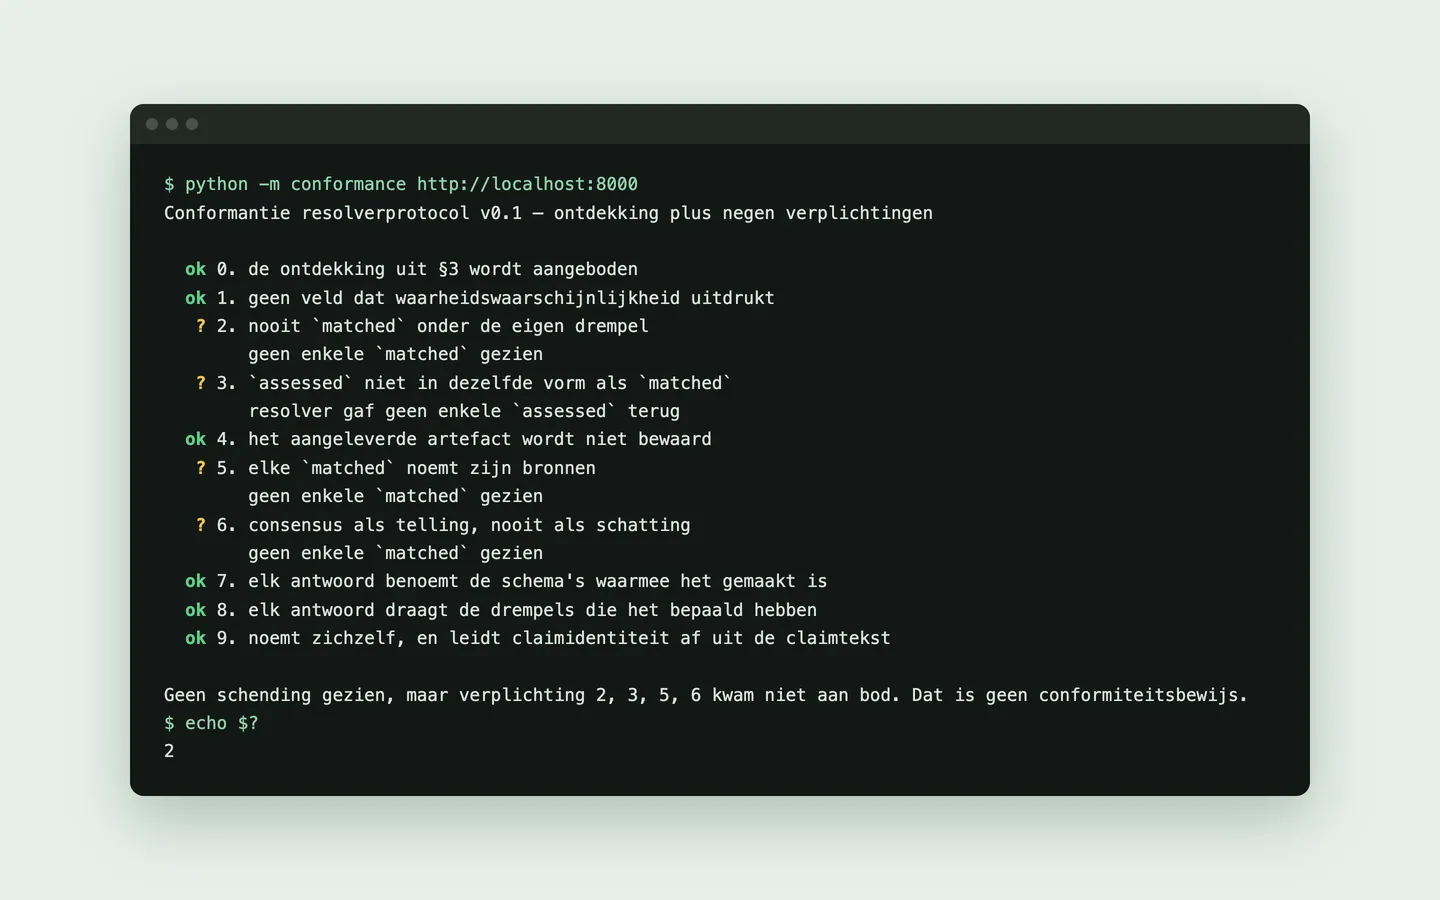
Wat een zoeklaag als Doublecheck moet doen, staat los beschreven als protocol. Daar hoort een eigen test bij, die je tegen elke zoeklaag kunt draaien, ook tegen een die iemand anders bouwt. Tegen Doublecheck vond de test geen schending. Vier verplichtingen kwamen niet aan bod, en dat meldt hij er zelf bij: dit is geen bewijs.
Betwisten, met alleen een vingerafdruk
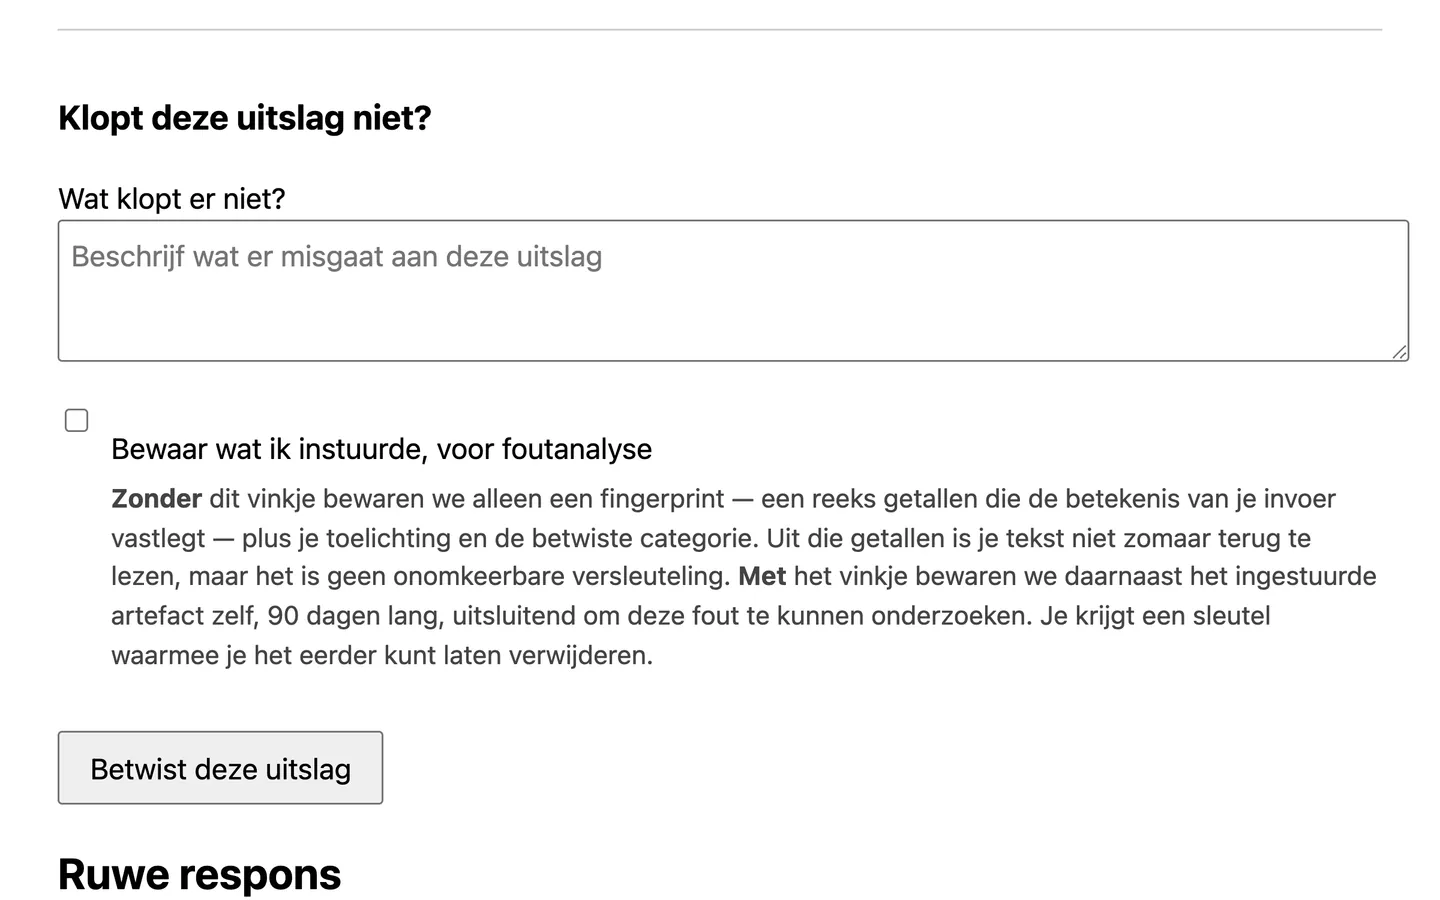
Wat je instuurt, bewaart Doublecheck niet. Alleen als je een uitslag betwist, houden we iets vast: een vingerafdruk van je invoer, je toelichting en de uitslag. Je invoer zelf bewaren we pas als je dat aanvinkt, negentig dagen lang voor foutanalyse. Je krijgt er een sleutel bij waarmee je hem eerder laat verwijderen.
Vijf fouten die geen drempel wegneemt
In onze eigen meting koppelde de tekstroute 5 van de 1.550 paren verkeerd, en de beeldroute 0 van de 4.000. Doublecheck vond 64,8 procent van de paren terug. Dat is bewust, want hij laat liever een factcheck liggen dan dat hij de verkeerde koppelt. De vijf fouten zijn bekend: twee keer een ingekorte bewering, twee keer een verdraaide en één keer een ontkenning. Geen drempel haalt ze weg zonder nieuwe fouten te maken.
De beeldroute is gemeten op een eigen testindex, want de open factcheckdata bevat geen beelden. Een bijgesneden beeld herkent Doublecheck nog niet.
Een tweede vraag is nog onderzoek: herhaalt een tekst van een taalmodel een weerlegde bewering in eigen woorden? In 107 echte documenten vond Doublecheck geen van de 28 gevallen, en alle zeven meldingen waren fout. Ze stonden vooral op factcheckpagina's, die de bewering citeren voordat ze hem weerleggen. In de 46 documenten die er niets mee te maken hadden, kwam geen enkele valse melding.
Wat we eruit hebben geleerd
- 01
Zes keer ging hetzelfde mis. Een hulpmiddel nam stilletjes aan dat tekst in het Latijnse schrift staat. Omdat de tests Latijnse invoer gebruikten, ging de score er zelfs op vooruit. Denk aan hoofdletters, die het Arabisch niet kent, of een lettertype zonder Chinese, Japanse en Koreaanse tekens. Nu loopt een controle elke tekstfunctie langs 24 schriften.
- 02
Een drempel hoort bij één vraag. De grens voor de vraag of iets dezelfde bewering is, bleek te streng voor de vraag of een tekst hetzelfde zegt in andere woorden. Dat zag je pas op echte documenten.
- 03
Lees de licentie voordat je de data leest. Het eerste corpus kwam uit een API van Google, en die voorwaarden verbieden een eigen database en doorgeven. Alles is omgezet naar de open feed van Data Commons en opnieuw gemeten.
- 04
Een taal die het model niet kan lezen, maakt stille fouten. Drie talen gaven samen 71 procent valse koppelingen, op een manier die geen enkele benchmark zag. Sindsdien meten we eerst of het model een taal aankan, en pas dan mag hij erin.
Letters en kleuren
- Testpagina
- Systeemletter
- Verwijdersleutel
- IBM Plex Mono
- #F4F4F4het vak met de ruwe respons en de sleutel
- #444444uitleg onder de velden
- #CCCCCChet kader om de uitslag
- #23262Bhetzelfde vlak in de donkere stand
- #B9BEC7uitleg in de donkere stand
- Bewust kaal: Doublecheck is een laag voor andere apps, en de testpagina is gereedschap om te zien wat hij teruggeeft, met het ruwe antwoord eronder.
- Achtergrond en tekst volgen de kleuren van het systeem, zodat de pagina in de donkere stand leesbaar blijft.
- Uitgelezen uit de code op 30 september 2026.
Onder de motorkap
- Invoer
- FastAPI
- POST /resolve
- Tekst of beeld
- Lezen
- Tesseract
- Vijf talen
- Minimaal 12 tekens
- Tekst vergelijken
- sentence-transformers
- Meertalig MiniLM
- 384 getallen
- Beeld vergelijken
- PDQ
- 256 bits
- 31 bits verschil
- Opslag en zoeken
- SQLite
- numpy
- Alles langs
- Toetsen
- pytest
- Conformantietest
- 24 schriften
Voor wie verder wil lezen
Hoe het precies werkt
De index komt uit de ClaimReview-feed van Data Commons.
De index komt uit de ClaimReview-feed van Data Commons. Elke bewering krijgt een naam die volgt uit haar eigen tekst, dus heeft dezelfde bewering op elke machine dezelfde naam. De taal wordt herkend, en alleen talen van de gemeten lijst mogen erin. Beweringen die vrijwel hetzelfde zeggen, komen in één groep. Zo zie je hoeveel onafhankelijke uitgevers er iets over schreven.
Elke vingerafdruk draagt de versie van het model waarmee hij gemaakt is. Draait Doublecheck met een ander model dan de index, dan zoekt hij niet. Het oordeel van een factchecker gaat letterlijk mee. Daarnaast wordt het teruggebracht tot een paar vaste woorden, zoals onwaar of onbekend, zodat je oordelen uit verschillende talen naast elkaar kunt leggen.
Er staat meer testcode dan code: bij de laatste balans 9.305 regels test tegen 8.037 regels productie. Metingen die niet klopten, staan als ingetrokken in het benchmarkdocument. Zo zie je hoe de cijfers tot stand kwamen.
Waar het nu staat
Af zijn de zoeklaag voor tekst en beeld, de index van 79.676 beweringen in 38 talen, de testpagina, het betwisten en het protocol met zijn eigen test.
Af zijn de zoeklaag voor tekst en beeld, de index van 79.676 beweringen in 38 talen, de testpagina, het betwisten en het protocol met zijn eigen test. Doublecheck draait bij ons en is niet openbaar.
Nog niet af zijn de vijf bekende fouten in de tekstroute en het herkennen van bijgesneden beelden. Bijna een kwart van de oordelen is nog niet in een vast woord te vangen. Voordat het corpus kan groeien, is een echte zoekindex nodig.
Een browserextensie en een iOS-app om een screenshot te delen liggen als onderdeel klaar in Verifyr, ons eerdere experiment. Op de lijst daarna staan een naam, metingen op echte data, en die extensie en app bovenop Doublecheck.
Wat is Doublecheck?
Een experiment van Ideelab: een zoeklaag die een screenshot of een stuk tekst koppelt aan factchecks die al bestaan. Je krijgt terug wie de bewering uitzocht, wanneer en wat eruit kwam, met de bron erbij.
Zegt Doublecheck of een bewering waar is?
Nee. Doublecheck zegt welke factcheckers een bewering al uitzochten en wat zij schreven, met de bron erbij. Een eigen oordeel, een score of een percentage over waarheid zit er niet in.
Wat kun je bij Doublecheck insturen?
Een screenshot of een stuk tekst. Uit een beeld leest Doublecheck eerst de tekst, in het Nederlands, Engels, Duits, Frans of Spaans.
Bewaart Doublecheck wat ik instuur?
Nee. Betwist je een uitslag, dan bewaren we een vingerafdruk van je invoer, je toelichting en de uitslag. Je invoer zelf houden we alleen vast als je dat aanvinkt: negentig dagen, voor foutanalyse, met een sleutel om hem eerder te laten verwijderen.
Waar haalt Doublecheck de factchecks vandaan?
Uit de open feed van Data Commons, onder een licentie die doorgeven toestaat: 80.555 factchecks van 1.596 uitgevers.
Kan ik Doublecheck al gebruiken?
Nog niet. Doublecheck draait bij ons en is niet openbaar.